Równoległe rozpoznanie tylko do odczytu. Fakty z kodu trafiają do wspólnego raportu.
SKILL // KROK 02 ŁAŃCUCHA
/10x-research - dowody z repozytorium
Gdy pomiarom nie można ufać, buduje się własne przyrządy - ten skill jest przyrządem do mierzenia kodu.Ten skill jest przyrządem do mierzenia kodu, zanim zapadną decyzje. /10x-research odpowiada na pytanie badawcze równoległymi subagentami i zapisuje ustalenia z referencjami plik:linia do research.md - kolejne kroki czytają fakty z dysku, nie z pamięci rozmowy.
/10X-RESEARCH // RÓWNOLEGŁY POMIAR ZBIEGA W JEDEN ARTEFAKT
Problem: decyzje na zatrutych danych
„Nie ufaj pomiarowi, którego nie wykonałeś własnym przyrządem."
- odruch naukowców po tym, jak wszechświat zaczął migotaćNajwiększym sabotażystą planu jest fałszywe „wiem, jak to działa" - wiedza sprzed trzech refaktorów, cudzy kod, duże repozytorium. /10x-research zastępuje założenia dowodami z repozytorium: przeczesuje kod, historię decyzji i realne zachowanie systemu, a wynik zapisuje na dysku.
Artefakt jest sednem: research w pamięci rozmowy znika z kontekstem, research w pliku przeżywa sesję i staje się wejściem dla /10x-plan - plan powstaje na faktach, które można zacytować z numerem linii.
najbardziej przydaje się w cudzym, starym lub dużym kodzie - wszędzie tam, gdzie fałszywe „wiem" kosztuje najwięcej i gdzie plan bez ugruntowania byłby zgadywaniem.
Agent najpierw poznaje fakty z kodu, zależności i istniejące wzorce, zanim zaproponuje rozwiązanie.
Z pytania badawczego do dokumentu z dowodami
Wejściem jest pytanie badawcze plus pliki wskazane przez użytkownika - te skill czyta w całości zanim ruszy cokolwiek innego, w głównym kontekście, nie w subagentach. Jeśli istnieje context/foundation/lessons.md, jego reguły są przyjmowane z góry: co zespół już zaakceptował, tego nie trzeba badać od nowa.
Wyjściem jest research.md w folderze zmiany - jeden artefakt researchu na zmianę. Pytania follow-up nie tworzą nowych plików: dopisują się do tego samego dokumentu jako osobna sekcja z adnotacją w frontmatterze.
- Wejście
- pytanie badawcze + wskazane pliki (czytane w całości) + opcjonalnie change-id
- Wyjście
- research.md w context/changes/<change-id>/ z metadanymi (data, commit, branch, temat)
- Status
- change.md przechodzi z new na preparing; brak folderu = tworzony jak w /10x-new
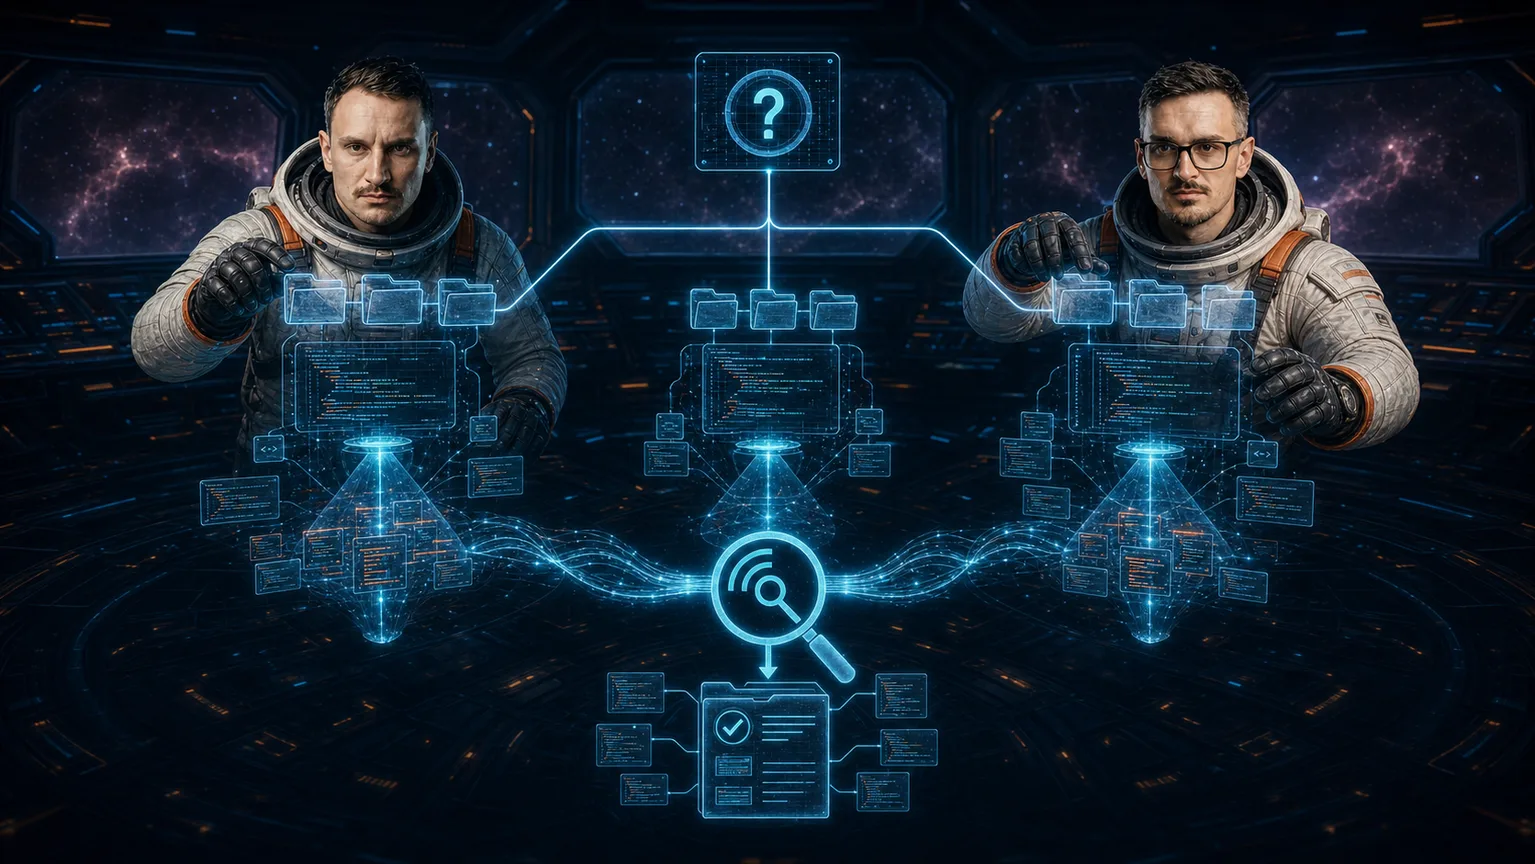
Jedno pytanie uruchamia równoległe, bezpieczne skany, które kończą się wspólnym zestawem dowodów.
Dekompozycja, równoległy pomiar, synteza
- 01 · Lektura
- pliki wymienione przez użytkownika czytane w całości w głównym kontekście - żadnych limitów, żadnego delegowania tej lektury.
- 02 · Dekompozycja
- pytanie rozbijane na obszary badawcze, które potem złożą się w odpowiedź; każdy obszar dostaje widoczne dla użytkownika zadanie na liście postępu.
- 03 · Zakres
- doprecyzowanie z użytkownikiem: szerokość, głębokość, punkt ciężkości (2-4 konkretne opcje na pytanie). Pomijane, gdy zapytanie jest jednoznaczne i wąsko zakrojone.
- 04 · Subagenci
- 2-4 równolegle, każdy w swoim wymiarze: szybkie wyszukiwanie plików i wzorców, wcześniejsze decyzje w context/changes/ i context/archive/, głęboka analiza działania systemu.
- 05 · Synteza
- start dopiero, gdy wrócą wszyscy; ustalenia z żywego kodu mają pierwszeństwo, historia jest kontekstem uzupełniającym; wszystko spina się referencjami plik:linia.
- 06 · Zapis
- metadane (commit, branch, data) zbierane przed pisaniem - dokument nigdy nie powstaje z placeholderami; przy wypchniętym commicie referencje dostają permalinki do GitHuba.
subagenci dostają zadania tylko do odczytu i mają zwracać konkretne referencje plik:linia oraz wzorce użycia - nie ogólniki i nie same definicje.
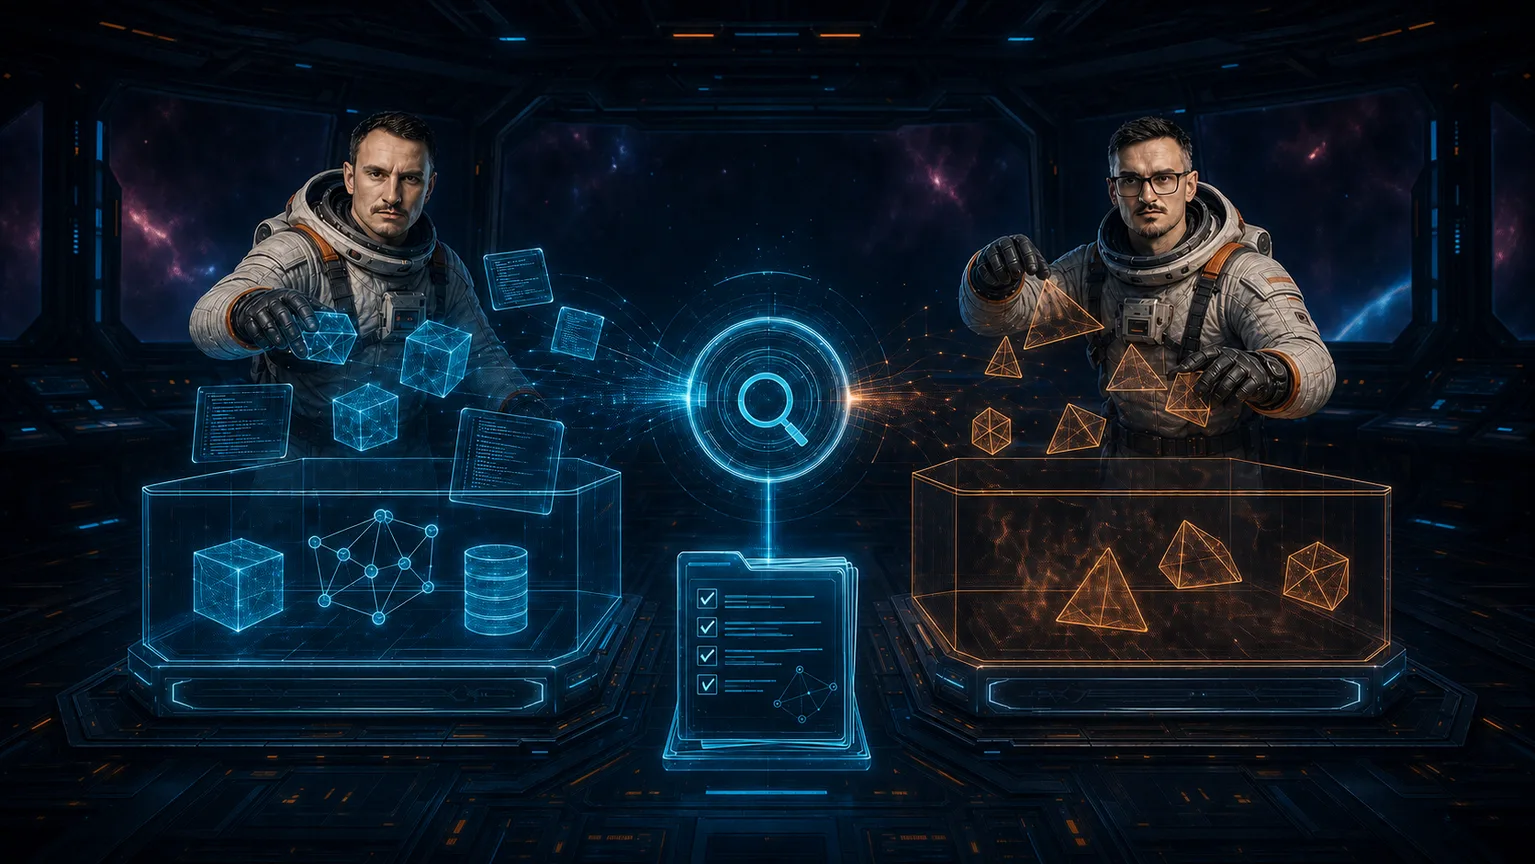
Fakty z kodu i założenia mają osobne tory, więc plan nie opiera się na pewnie brzmiącym zgadywaniu.
research.md - dokument samowystarczalny
Dokument otwiera frontmatter z pełnym kontekstem czasowym: data z timezone, badacz, commit, branch, repozytorium, temat, tagi. Dzięki temu czytelnik za trzy miesiące wie, względem jakiego stanu kodu te ustalenia były prawdziwe.
Sekcje prowadzą od skrótu do szczegółu: najpierw odpowiedź na pytanie, potem dowody per komponent, na końcu wnioski architektoniczne i to, czego nie udało się rozstrzygnąć. Pytania follow-up trafiają na dół z własnym znacznikiem czasu.
- Summary
- wysokopoziomowa odpowiedź na pytanie badawcze
- Detailed Findings
- ustalenia per komponent/obszar z referencjami i powiązaniami między komponentami
- Code References
- lista ścieżka:linia z opisem, co tam jest - grunt pod plan
- Architecture Insights
- wzorce, konwencje i decyzje projektowe odkryte po drodze
- Historical Context
- wnioski z context/changes/ i context/archive/ z referencjami do tamtych dokumentów
- Open Questions
- obszary wymagające dalszego zbadania - jawnie, zamiast udawać kompletność
Każdy istotny wniosek ma ślad prowadzący do kodu; założenia są oznaczone i nie udają faktów.
Czego /10x-research nie robi
- Nie zmienia kodu
- badanie jest w całości odczytowe - jedyny zapis to research.md i podbicie statusu w change.md.
- Nie ufa historii w ciemno
- świeży research żywego kodu zawsze przed archiwum - wcześniejsze zmiany to kontekst uzupełniający, nie zamiennik czytania.
- Nie planuje
- research ustala fakty; decyzje projektowe i etapy to praca /10x-plan.
- Nie mnoży artefaktów
- jeden research.md na zmianę; pytania follow-up dopisują się do istniejącego pliku. Zmiana zarchiwizowana = odmowa i wskazanie /10x-new.
wróć do kroku 02 (research) na stronie Core Skills Chain - kontekst całego łańcucha i sąsiednie kroki.
Research może działać równolegle, ale nie zmienia repo — dzięki temu rozpoznanie pozostaje bezpieczne i odwracalne.